

Warum exakte Vergleiche scheitern
Ein klassischer Chatbot mit festen Antworten lässt sich prüfen wie jede Software: Eingabe rein, erwarteter Text raus. Ein Bot auf Basis eines Sprachmodells antwortet auf dieselbe Frage einmal mit „Ihr Termin ist bestätigt“ und einmal mit „Alles klar, der Termin steht“. Beide Antworten sind richtig, ein Textvergleich meldet trotzdem einen Fehler.
Die Folge: Entweder schlagen die Tests ständig fehl und werden ignoriert, oder sie werden so locker formuliert, dass sie nichts mehr prüfen.
Aussagen prüfen statt Wortlaut
Die Lösung ist, eine Ebene höher zu prüfen. Statt eines festen Satzes erwartest du eine Aussage:
| Statt | Besser |
|---|---|
| „Ihr Termin am 3. Mai um 10 Uhr ist bestätigt.“ | Der Bot bestätigt den Termin am 3. Mai um 10 Uhr. |
| „Bitte nennen Sie Ihre Kundennummer.“ | Der Bot fragt nach der Kundennummer. |
| „Dazu kann ich leider keine Auskunft geben.“ | Der Bot lehnt die Rechtsauskunft ab und nennt den Kontakt. |
Ein Sprachmodell liest danach das Gespräch und entscheidet für jede Aussage: gefallen oder nicht. Gute Werkzeuge liefern dazu eine Begründung.
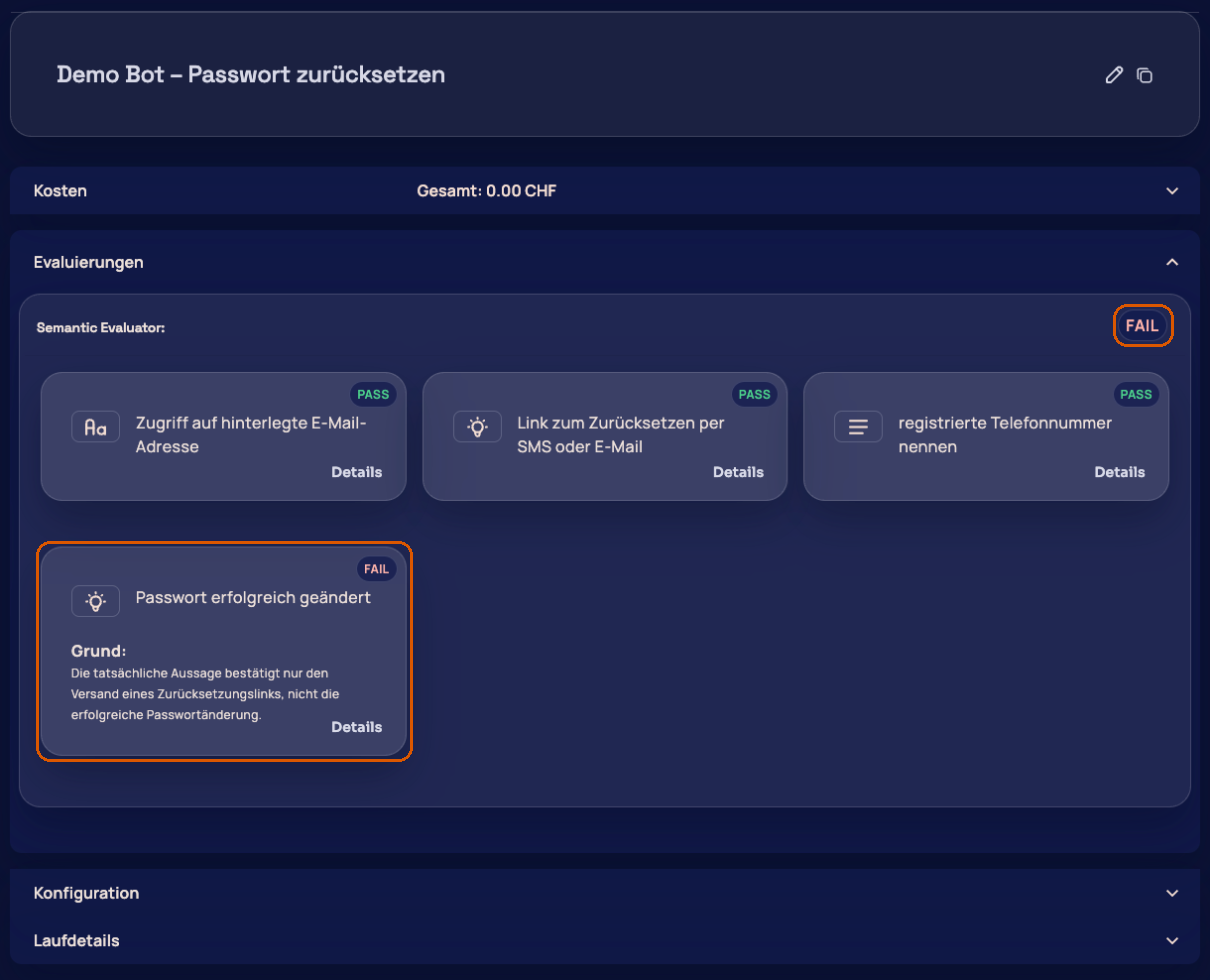
So formulierst du erwartete Aussagen
- Konkret. „Der Bot nennt die Rückgabefrist von 30 Tagen“ lässt sich prüfen, „Der Bot ist hilfreich“ nicht.
- Eine Aussage pro Zeile. So zeigt das Ergebnis genau, was gefehlt hat.
- Das Ergebnis, nicht den Weg. Wie viele Rückfragen der Bot stellt, ist meist egal. Entscheidend ist, was am Ende feststeht.
- Auch Verbote. „Der Bot nennt keinen Preis“ ist eine prüfbare Aussage.
Das ganze Gespräch testen, nicht eine Antwort
Ein einzelnes Frage-Antwort-Paar sagt wenig über einen Bot, der über mehrere Schritte ein Anliegen bearbeitet. Fehler entstehen oft erst im Verlauf: Der Bot vergisst eine Angabe vom Anfang, fragt doppelt oder bricht nach einer Korrektur ab.
Deshalb lohnt sich ein Test, der das Gespräch von Anfang bis Ende führt. Weil der Bot frei antwortet, muss auch die Gegenseite reagieren können: Ein festes Skript passt nach der ersten unerwarteten Rückfrage nicht mehr.
So macht es gentesty
In gentesty beschreibst du ein Szenario und die erwarteten Aussagen. gentesty führt das Gespräch mit deinem Bot selbst und reagiert dabei auf das, was der Bot sagt. Danach bewerten Sprachmodelle jede Aussage, nach Bedeutung oder, wo es nötig ist, wörtlich. Eigene Evaluatoren gibt es ab dem Business-Plan.
Weiter zu Chatbots testen oder zum Artikel Regressionstests für Chatbots und Voicebots.
Häufige Fragen
Kann man einen LLM-Chatbot überhaupt automatisiert testen?
Ja. Statt den Wortlaut zu vergleichen, prüft man, ob bestimmte Aussagen im Gespräch gefallen sind. Diese Prüfung übernimmt ein Sprachmodell, das die Antwort nach ihrer Bedeutung beurteilt.
Ist es nicht unzuverlässig, wenn ein Sprachmodell ein anderes bewertet?
Es ist zuverlässiger, als es klingt, wenn die erwarteten Aussagen konkret formuliert sind. Wichtig ist, dass die Bewertung ihre Entscheidung begründet, damit du Fehlurteile erkennst und die Aussage schärfen kannst.
Wann ist ein exakter Vergleich trotzdem sinnvoll?
Bei Inhalten, die wörtlich stimmen müssen: rechtliche Hinweise, Beträge, Telefonnummern oder Vertragsnummern. Für alles andere ist der Vergleich nach Bedeutung die bessere Wahl.